餐饮配送备货损耗控制的需求预测建模
餐饮配送备货损耗控制的需求预测建模
数据来自公开的食品需求预测数据集,覆盖 77 个履约中心、51 种餐品,包含 145 周历史订单,共 456,548 行;测试集覆盖未来 10 周,共 32,573 行。每一行对应一个履约中心、一个餐品和一周的订单量,特征包括结算价、基准价、邮件促销、首页推荐等。
预测单元是履约中心与餐品的组合,而不是单个中心或单个餐品的总量。该粒度更贴近按履约中心备货的实际场景:同一餐品在不同中心的需求水平可能差异悬殊,仅预测总量无法指导各履约中心的具体备货量。任务采用直接多步预测,一次输出未来 10 周,避免递归预测中误差逐步累积。
数据探查
训练集和测试集均没有缺失值,也没有重复的中心餐品周记录。目标变量 num_orders 右偏明显:最小值 13,25 分位为 54,中位数 136,均值 262,75 分位为 324,99 分位为 1,796,最大值 24,299;偏度 6.93,执行 log1p 变换后降至 -0.02。右偏会使平方误差被少数大单量主导,因此在对数空间进行训练与评估,使模型更多关注相对差异。
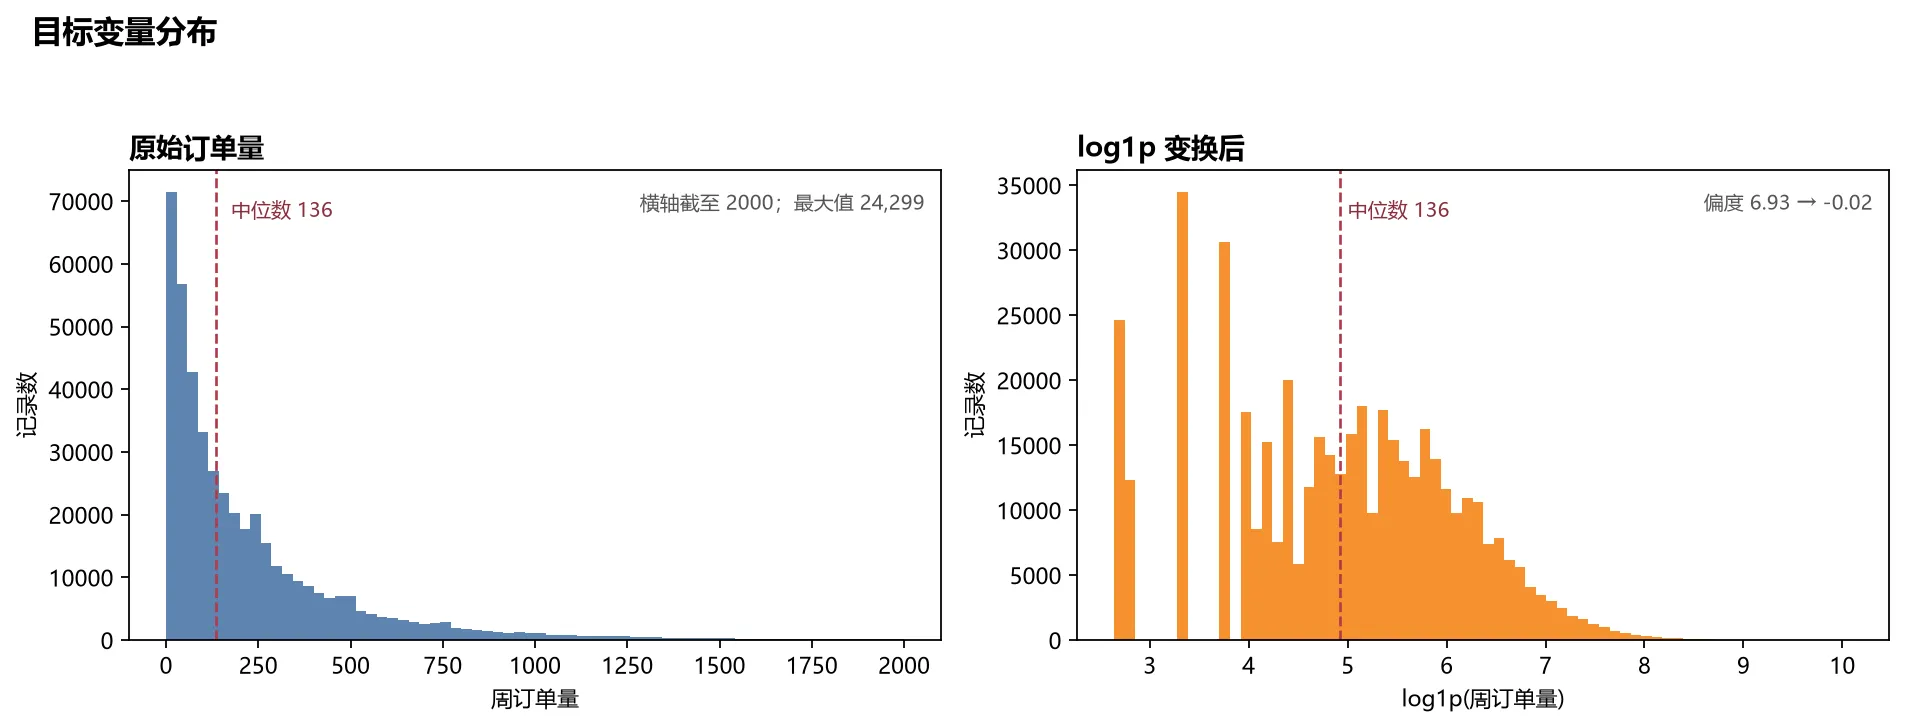
左:原始订单量,横轴截至 2000;右:log1p 变换后的分布。原始目标右偏明显,变换后接近对称。
促销是数据中最强的行级信号。出现邮件促销的记录占 8.1%,其平均订单量为 631,为无邮件促销时的 2.75 倍;出现首页推荐的记录占 10.9%,其平均订单量为 595,为无首页推荐时的 2.69 倍。两种促销存在叠加效应:按组合分别统计,无促销为 211,仅邮件为 431,仅首页为 456,双促销为 816。
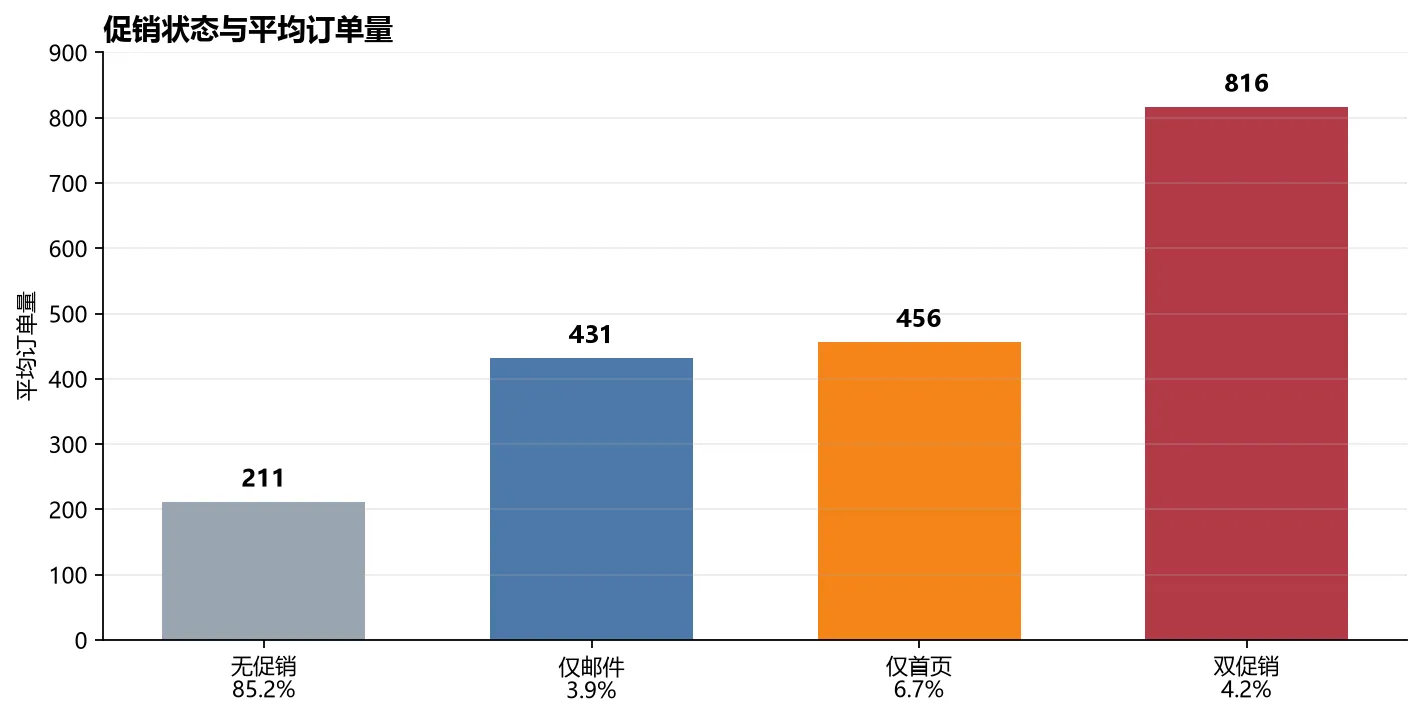
按促销组合拆分的平均订单量,柱下标注记录占比。
价格方面,结算价范围为 2.97 至 866.27,基准价范围为 55.35 至 866.27,两者分布均呈明显长尾;25.4% 的结算价高于基准价,即负折扣,折扣中位数为 0.001。结算价与对数订单量的相关系数约为 -0.39,表明价格是有效信号,但折扣结构并不规则,不宜简单按折扣率线性处理。上述信息仅反映预测意义上的关联。
数据包含 14 个餐品类别、4 个菜系。不同餐品的需求量级差异显著:Rice Bowl 的平均订单量约为 625,Biryani 仅为 31;按中心与餐品的组合统计,组合均值为 13.7 至 2,305.8,相差约 168 倍。由此可见,相较于全局价格或促销特征,中心与餐品的标识以及组合自身的历史统计更能解释需求差异。
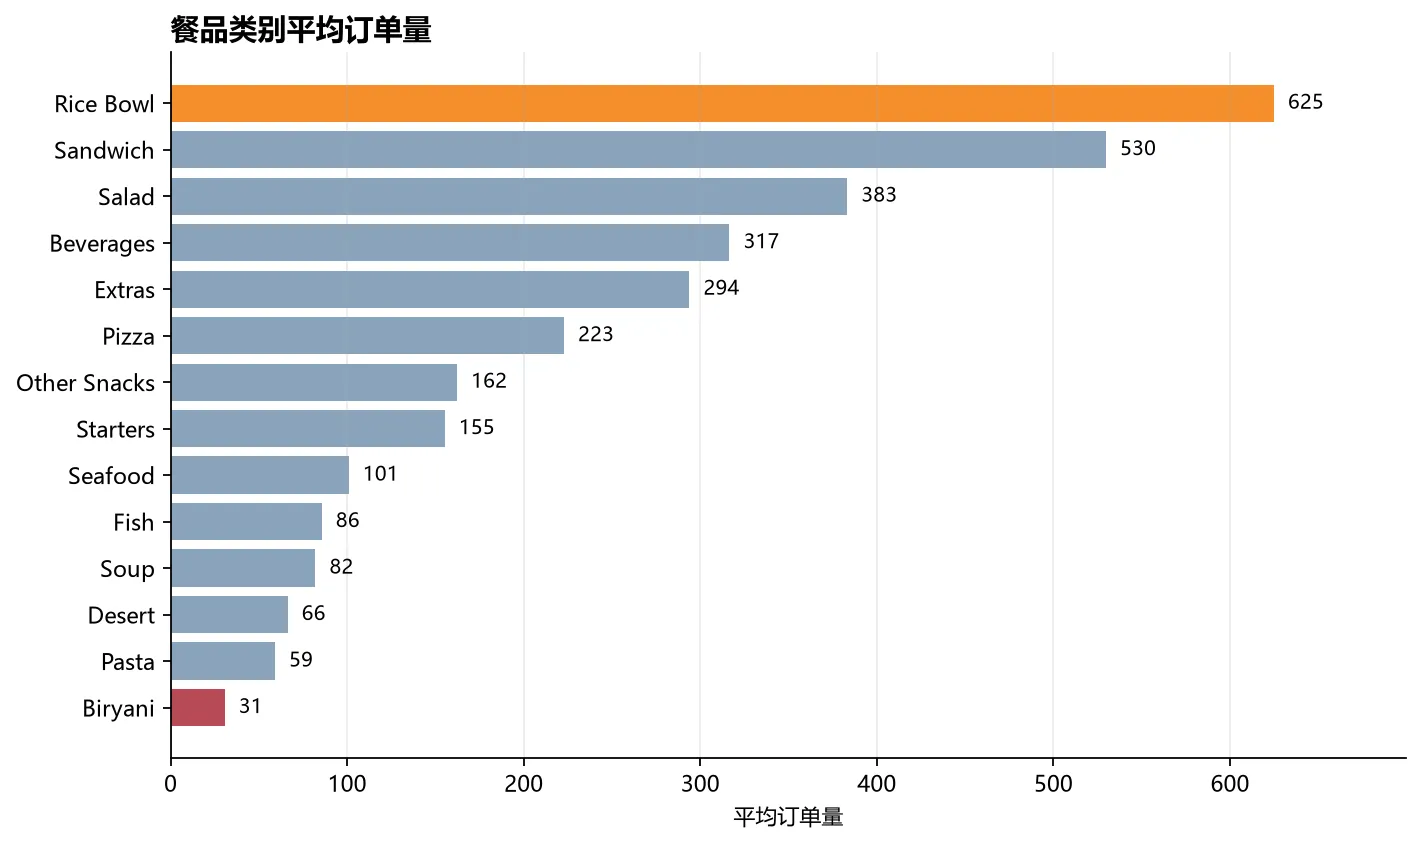
餐品类别的平均订单量差异很大,Rice Bowl 约 625,Biryani 约 31。
此外,需求还会随时间缓慢下降:最初 10 周的周均订单量为 290.5,最后 10 周降至 227.3,降幅约 22%。因此验证不宜采用随机划分,而须保证训练段在前、验证段在后,以捕捉这种漂移。
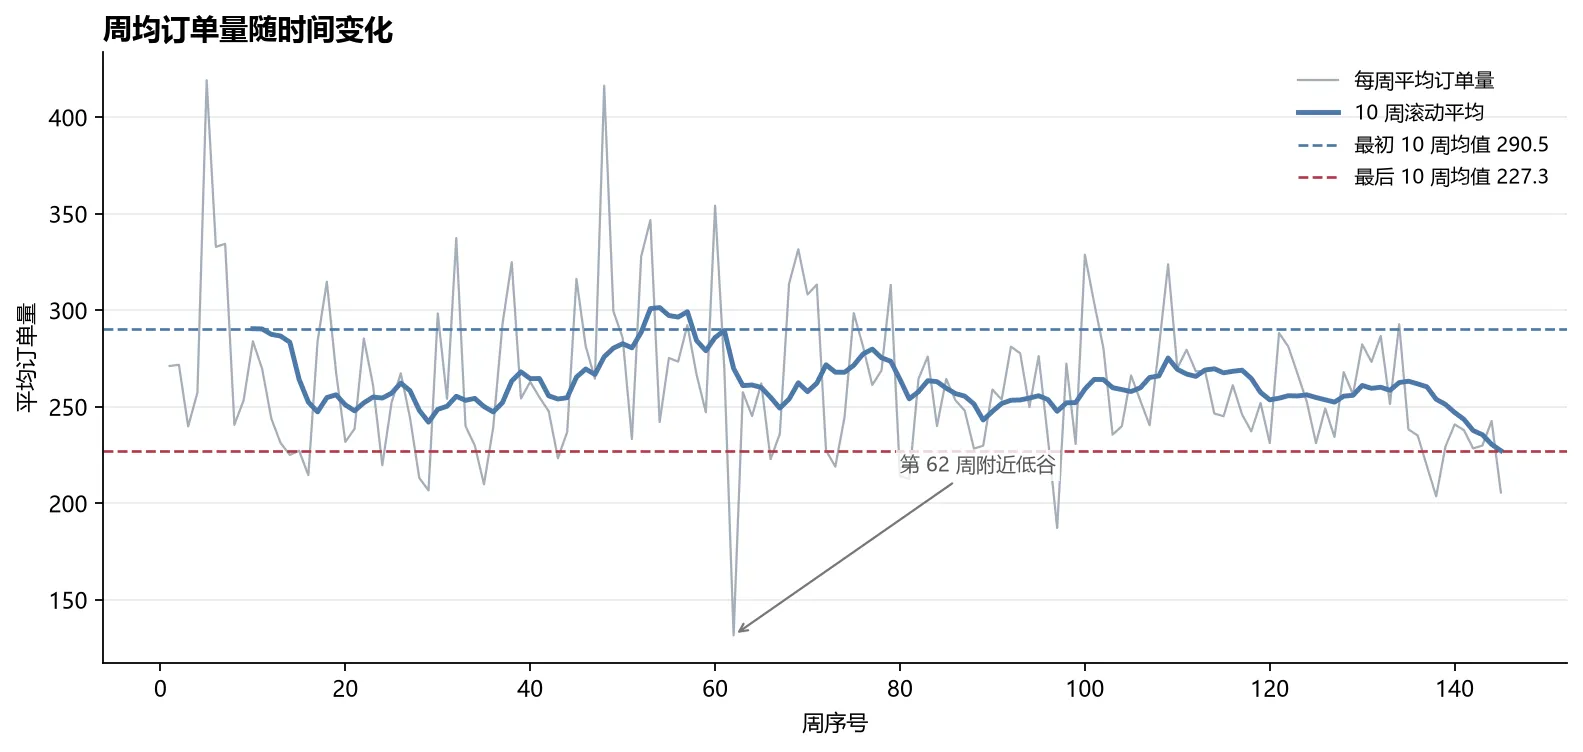
每周平均订单量;虚线为最初 10 周与最后 10 周的均值,分别为 290.5 和 227.3。
组合覆盖也不完整。训练集有 3,597 个中心餐品组合,历史长度中位数为 140 周,但只有约 35% 覆盖完整 145 周;2,129 个组合有中间断档,部分组合中途上线或停售。测试集有 3,548 个组合,其中 3 个从未在训练中出现。滞后特征因此保留缺失值,树模型可直接处理,无需为填补缺失引入额外假设。
特征与防泄漏
最终特征集共 36 列,分为六组:
| 特征组 | 列数 | 内容 | 作用 |
|---|---|---|---|
| 原始数值与促销 | 4 | checkout_price、base_price、emailer_for_promotion、homepage_featured | 当期价格与促销状态 |
| 价格派生 | 6 | base_log、checkout_log、discount、neg_discount、price_prev_diff、price_up | 价格水平、折扣与周环比 |
| 日历 | 3 | week、week_sin、week_cos | 周序位置与季节形状 |
| 目标滞后 | 9 | 滞后 10 至 12、EWM(指数加权均值)平移 10 至 15 | 组合自身近期需求 |
| 滑动统计 | 6 | 10/26/52 周均值与标准差,平移 10 | 组合中期水平与波动 |
| 元信息 | 8 | center_id、meal_id、category、cuisine、center_type、city_code、region_code、op_area | 中心与餐品的固定差异 |
核心特征的计算逻辑如下,其关键在于先按训练截止周将目标置空,再在组内做平移:
# 目标派生特征 核心逻辑
y = np.log1p(out["num_orders"].astype(float))
if train_end is not None:
    # 预测起点之后的目标不参与特征
    y = y.where(out["week"] <= train_end)

g1, g2 = out["center_id"], out["meal_id"]
# _group_ewm / _group_roll 为组内 EWM 与滚动统计的辅助函数

for L in (10, 11, 12):
    out[f"y_lag{L}"] = y.groupby([g1, g2], sort=False).shift(L)

for sh in (10, 11, 12, 13, 14, 15):
    s = y.groupby([g1, g2], sort=False).shift(sh)
    out[f"y_ewm0.5_s{sh}"] = _group_ewm(s, g1, g2, 0.5)

for w in (10, 26, 52):
    s = y.groupby([g1, g2], sort=False).shift(10)
    out[f"y_rmean{w}_s10"] = _group_roll(s, g1, g2, w, "mean")
    out[f"y_rstd{w}_s10"] = _group_roll(s, g1, g2, w, "std")
目标派生特征是本方案的核心。由于需一次性预测未来 10 周,所有滞后与滑动统计的起点均设在 10 周之前:滞后仅取 10、11、12 周,EWM 采用平移(shift)10 至 15,滚动统计采用平移 10。如此,每个预测点所用的历史窗口均不会越过预测起点,既无需以模型预测值回填,也不会将验证段或测试段的目标信息带入特征。
价格与促销采用预测时点已确定的信息;类别特征采用固定整数编码,不采用目标编码;目标派生特征按组合分组计算。滞后与滚动统计在早期产生的缺失值予以保留,交由 LightGBM 处理。组合中途上线或停售本属常见现象,是数据结构的一部分,不宜作为异常数据删除。
评估方法
数据不含官方测试标签,所有模型选择均在本地回测上完成。采用两个前后错开的滚动窗口替代随机划分:
| 窗口 | 训练段 | 训练行数 | 验证段 | 验证行数 |
|---|---|---|---|---|
| A / 较早 | 第 1 至 115 周 | 358,073 | 第 116 至 125 周 | 32,834 |
| B / 较近 | 第 1 至 135 周 | 423,727 | 第 136 至 145 周 | 32,821 |
每个窗口均以训练段在前、验证段紧随其后的方式划分,以模拟真实预测时仅能利用过去数据的情形。随机划分会使同一组合的不同周同时进入训练与验证,导致验证分数偏乐观,且无法反映时间漂移。
指标使用 RMSLE,即对 log1p 目标计算均方根误差(RMSE),衡量相对误差。为区分真实改进与随机波动,先测定噪声地板:同一配置更换不同随机种子时,RMSLE 的标准差约为 0.0008。因此以 0.002 作为有意义的改进阈值,并要求两个窗口同向改善方视为通过。关键结论采用 5 组随机种子重复确认,一般探索至少采用 3 组。
窗口和指标的实现:
# 评估协议 核心逻辑
WINDOWS = {"A": (115, 116, 125), "B": (135, 136, 145)}

def rmsle_log(y_log_true, y_log_pred):
    y_log_pred = np.clip(np.asarray(y_log_pred, dtype=float), 0.0, None)
    y_log_true = np.asarray(y_log_true, dtype=float)
    return float(np.sqrt(np.mean((y_log_true - y_log_pred) ** 2)))
模型与方案
在 36 列特征与同一套回测协议下,比较了三种梯度提升模型:
| 模型 | 窗口 A | 窗口 B | 单次训练耗时 | 种子数 |
|---|---|---|---|---|
| LightGBM | 0.49425 | 0.49520 | 约 20 秒 | 3 |
| XGBoost | 0.49716 | 0.49605 | 约 30 秒 | 3 |
| CatBoost | 0.49704 | 0.49907 | 5 至 8.5 分钟 | 2 |
分数为对应种子数的均值。LightGBM 在两个窗口上均优于另外两者,训练速度也明显更快,因此确定为主力模型。调参采用小规模网格搜索:学习率 0.03 与 0.05,叶子数 31、63、127,共 6 组配置,每组使用 2 组随机种子;其中学习率 0.03、800 棵树、127 个叶子的配置在两个窗口均略优,经 5 组随机种子确认后确定为基准配置。完整参数为 800 棵树、学习率 0.03、127 个叶子、min_child_samples 40、subsample 0.9、colsample 0.8、L2 正则 1.0。
最终方案为对两个配置取简单平均:其一为上述 LightGBM 基准,其二在相同参数下开启 extra_trees,使分裂阈值更具随机性。extra_trees 在窗口 B 上提升明显,但在窗口 A 上变差;两者在对数空间等权平均后,窗口 A 基本持平,窗口 B 明显改善。最终方案的窗口 A 为 0.49008,窗口 B 为 0.48434。
| 方案 | 窗口 A | 窗口 B | 说明 |
|---|---|---|---|
| LightGBM 基准 | 0.49038 | 0.49465 | 5 组种子 |
| extra_trees 配置 | 0.49536 | 0.48358 | 5 组种子 |
| 两成员平均 | 0.49008 | 0.48434 | 采纳 |
| 5 成员等权 | 0.48994 | 0.48633 | 未采纳 |
| 跨窗权重 | 0.49186 | 0.49036 | 未采纳 |
5 成员池与权重寻优来自较早实验,其种子数与最终两成员方案不完全一致;数字仅用于指示方向。5 成员池在窗口 A 略优,但在窗口 B 受较弱成员影响而变差;跨窗权重在两个窗口均更差。三个引擎的预测相关系数介于 0.989 至 0.996 之间:按 A/B 窗口顺序,LightGBM 与 XGBoost 为 0.996/0.995,LightGBM 与 CatBoost 为 0.993/0.991,XGBoost 与 CatBoost 为 0.993/0.989。
最终集成包含两步:先分别得到两个成员各 5 组种子的预测,再在对数空间取平均。
# 最终集成 核心逻辑
LGB_SEL = dict(
    n_estimators=800, learning_rate=0.03, num_leaves=127,
    min_child_samples=40, subsample=0.9, subsample_freq=1,
    colsample_bytree=0.8, reg_lambda=1.0, extra_trees=True,
)

# p_lgb:LightGBM 基准的 5 组种子预测;p_et:extra_trees 配置的 5 组种子预测
v3_log = (p_lgb + p_et) / 2
orders = np.clip(np.expm1(v3_log), 0, None)
结果
将关键方案汇总对比,可见一条较为清晰的改进路径:
| 方案 | 窗口 A | 窗口 B | 说明 |
|---|---|---|---|
| 基础特征 + 原尺度目标 | 0.5867 | 0.5731 | CatBoost,300 轮 |
| 基础特征 + 对数目标 | 0.5190 | 0.5219 | 无时序特征 |
| 滞后与 EWM 特征 + LGBM 400 | 0.4989 | 0.4979 | 加入滞后与 EWM |
| 最终方案 | 0.4901 | 0.4843 | 两配置平均,各 5 组种子 |
上述各行所使用的主力模型不同,数字仅用于指示改进方向,并非严格消融实验;特征与模型的单独贡献在后文消融结果中分别确认。
目标对数化的收益最大:改用对数目标后,分数降至 0.519 / 0.522,两个窗口均改善约 0.05 至 0.07。加入滞后与 EWM 后,分数降至 0.499 / 0.498;再加入滑动统计与 extra_trees 平均,降至 0.490 / 0.484。相较于无时序特征的对数基线,最终方案在两个窗口分别降低 5.6% 与 7.2%,约 6% 至 7%。
Δ 为相对同口径基准的变化,负值表示更好;两个窗口同向且超过噪声阈值才视为有效。
| 尝试 | ΔA | ΔB | 结论 |
|---|---|---|---|
| 滞后 10 至 15 | +0.00092 | -0.00138 | 方向不一致 |
| 滞后含 26 周 | -0.00164 | +0.00010 | 方向不一致 |
| EWM 多 alpha | -0.00252 | +0.00092 | 方向不一致 |
| 去掉 EWM | +0.00624 | +0.00312 | 两窗均变差 |
| 动量 | -0.00581 | +0.00126 | 方向不一致 |
| 生命周期 | -0.00184 | +0.00343 | 方向不一致 |
| 价格上下文 + 促销历史 | +0.00598 | +0.00167 | 两窗均变差 |
| 滑动统计,2 组种子 | -0.00593 | -0.00158 | 临界 |
| 滑动统计,5 组种子确认 | -0.00441 | -0.00281 | 采纳 |
上述尝试中,仅滑动统计经 5 组随机种子确认后稳定通过;去掉 EWM 会使两个窗口同时变差;其余方向或两个窗口方向相反,或两个窗口同时变差。
最终提交的预测中位数为 124.3,均值 229.1,最大 5,495;训练集中位数为 136,均值为 262,说明模型在平方误差目标下趋于保守。
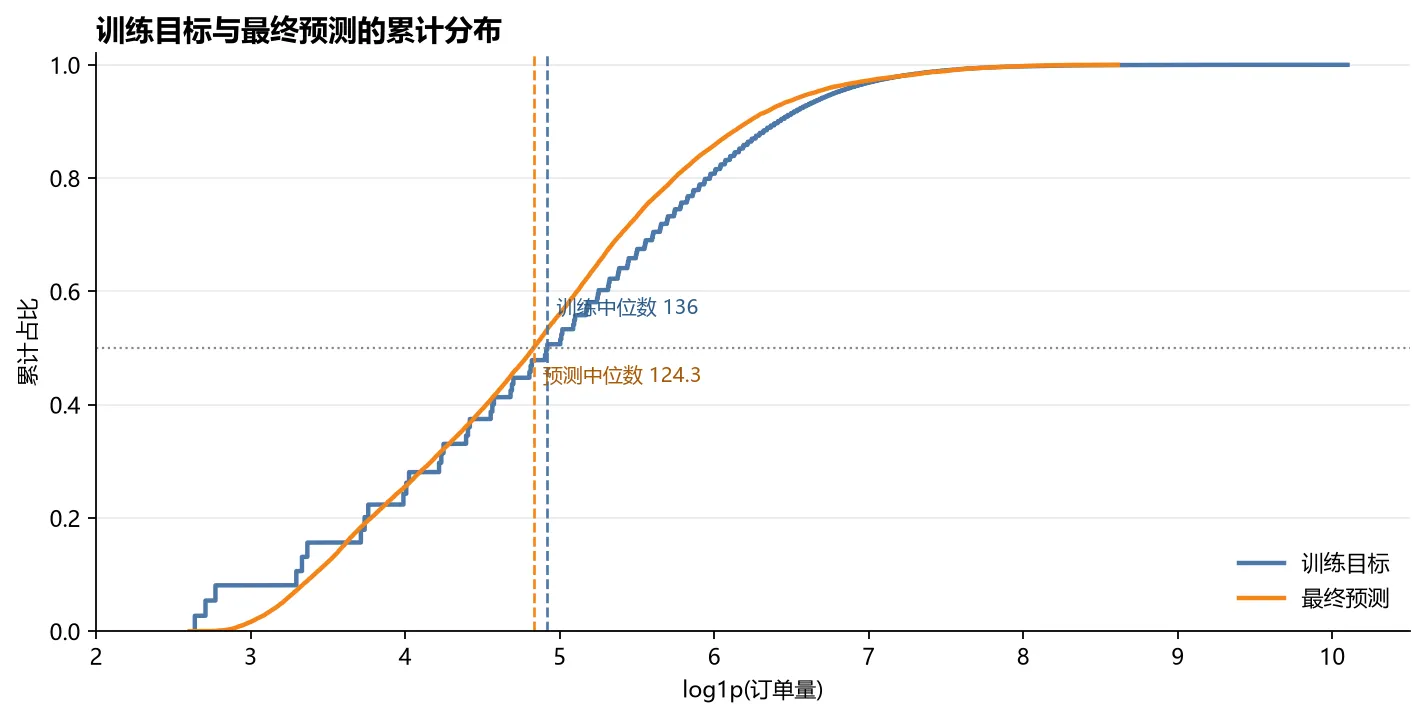
训练目标与最终预测的累计分布;最终预测中位数 124.3,训练中位数 136。
综观上述路径,收益最大的两个环节为目标对数化与时序特征,集成仅带来小幅但稳定的补充。以上分数均来自两个本地回测窗口,并非测试集成绩。